Wie bei den diskreten Zufallsgrößen treten auch bei den kontinuierlichen Zufallsgrößen gewissen Klassen von Verteilungsfunktionen immer wieder auf.
8.4.1Überblick
Folgende Klassen sind am häufigsten anzutreffen:
Gleichverteilung (siehe unten),
Normalverteilung (siehe unten),
Exponential-Verteilung (z.B. Lebensdauern oder Wartezeiten),
Studentsche t-Verteilung (tritt bei statistischen Untersuchen normalverteilter Zufallsgrößen auf),
-Verteilung (sprich: Chi-Quadrat-Verteilung; tritt bei statistischen Untersuchen normalverteilter Zufallsgrößen auf),
F-Verteilung (tritt bei statistischen Untersuchen normalverteilter Zufallsgrößen auf).
8.4.2Gleichverteilung
Bei gleichverteilten (kontinuierlichen) Zufallsgrößen treten alle Werte im Wertebereich gleich häufig auf. Misst man beispielsweise die Winkeldifferenz bei der Radposition eines Autos vor und nach einer hinreichend langen Fahrt, werden bei mehrfacher Wiederholung die gemessenen Werte alle einigermaßen gleichmäßig im Intervall verteilt sein.
Erwartungswert und Varianz einer auf dem Intervall gleichverteilten Zufallsgröße sind
und
(die entsprechenden Integrale sind leicht zu berechnen).
Die Verteilungsfunktion lässt sich ebenfalls leicht berechnen:
8.4.3Normalverteilung
Normalverteilte Zufallsgrößen treten sehr häufig auf. Beispielsweise führen praktisch alle Arten von Messprozessen (Länge, Masse, Temperatur,...) bei Einbeziehen eventueller Messfehler zu normalverteilten Zufallsgrößen. Den genauen Grund dafür werden wir in einem späteren Unterkapitel erhellen. Kurzfassung: Die Überlagerung vieler unabhängiger Fehlerquellen führt zu normalverteilten Messergebnissen.
Die beiden Parameter bei einer normalverteilten Zufallsgröße stimmen gerade mit Erwartungswert und Standardabweichung überein:
Die Verteilungsfunktion der Normalverteilung lässt sich nicht explizit als Formel angeben, da die Dichtefunktion keine als Formel darstellbare Stammfunktion besitzt. Die Auswertung der Verteilungsfunktion erfolgt durch numerische Integration (oder durch Ablesen aus Tabellen). Die meisten mathematischen Software-Bibliotheken bieten jedoch eine spezielle Funktion zu diesem Zweck an (z.B. scipy.stats.norm.cdf).
Source
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import norm as normal

fig, (ax1, ax2) = plt.subplots(2, 1, sharex=True)

x = np.linspace(-2, 1, 200)
for mu, sigma in [(0, 0.1), (0, 0.2), (0, 0.3), (-1, 0.3)]:
    p = normal.pdf(x, loc=mu, scale=sigma)
    F = normal.cdf(x, loc=mu, scale=sigma)
    ax1.plot(x, p, label=f'$\\mu={mu}$, $\\sigma={sigma}$')
    ax2.plot(x, F, label=f'$\\mu={mu}$, $\\sigma={sigma}$')
    ax1.set_xlim(-2, 1)

ax1.set_title('Dichtefunktionen der Normalverteilung')
ax2.set_title('Vertielungsfunktionen der Normalverteilung')
ax1.grid()
ax2.grid()
ax2.set_xlabel('x')
ax1.set_ylabel('p(x)')
ax2.set_ylabel('F(x)')
ax1.legend()
ax2.legend()
plt.show()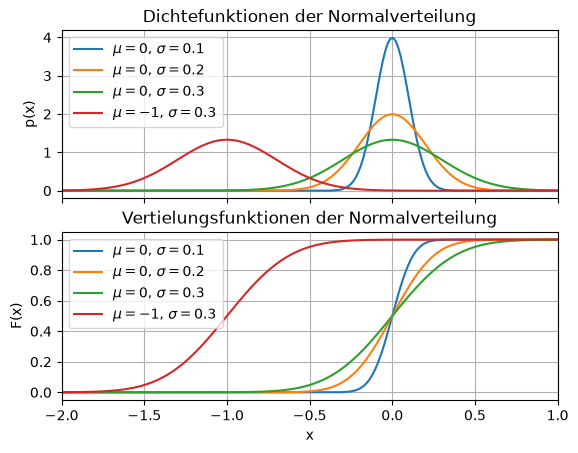
Die folgende wichtige Eigenschaft normalverteilter Zufallsgrößen lässt sich nur mühsam herleiten, sodass wir auf die Herleitung verzichten. Den hier verwendeten Begriff der Unabhängigkeit von zwei Zufallsgrößen führen wir im nächsten Unterkapitel präzise ein. Intuitiv ist er klar: Zwei Zufallsgrößen sind unabhängig, wenn sich das Eintreten zugehöriger Ereignisse in keiner Weise gegenseitig beeinflusst.
Beachte, dass das Bilden der Summe von zwei Zufallsgrößen nur sinnvoll ist, wenn beide Zufallsgrößen über dem selben Wahrscheinlichkeitsraum definiert sind. Insbesondere müssen beide Zufallsgrößen den selben Definitionsbereich besitzen, da die Summe zweier Funktionen mit unterschiedlichem Definitionsbereich nicht sinnvoll erklärt werden kann.
Folgenden Zusammenhang kann man sich leicht anhand der Dichtefunktion der Normalverteilung überlegen: